Project Glasswing: AI tìm lỗ hổng nhanh hơn con người sửa được
Hãy tưởng tượng bạn duy trì một thư viện mã nguồn mở được hàng triệu người dùng. Một buổi sáng, hộp thư của bạn nhận thêm 45 báo cáo lỗ hổng — tất cả do một chương trình quét AI gửi tới, không có con người nào xem trước. Đây không phải tình huống giả định: Daniel Stenberg, người duy trì curl, vừa trải qua đúng chuyện đó với Project Glasswing của Anthropic. Sau 7 tháng, Project Glasswing đã tìm ra 37.966 lỗ hổng — nhưng chỉ 217 cái được sửa. Nút thắt đã chuyển từ phát hiện sang khắc phục — bài này chỉ cách đọc đúng các con số cùng checklist xử lý báo cáo AI cho maintainer và đội bảo mật.
Project Glasswing là gì?
Project Glasswing là sáng kiến nghiên cứu lỗ hổng có phối hợp của Anthropic, ra mắt ngày 7/4/2026. Công cụ chính là Claude Mythos Preview — model chuyên tìm lỗ hổng bảo mật, chưa phát hành công khai. Mục tiêu tuyên bố khi ra mắt: tìm ra hàng nghìn lỗ hổng mức nghiêm trọng cao và tới hạn, rồi phối hợp công bố có trách nhiệm cho các maintainer mã nguồn mở.
Quy trình của Project Glasswing chạy qua 5 bước: AI quét mã nguồn mở và tạo ra các findings ứng viên; đội ngũ Anthropic xác thực thủ công từng finding; findings đã xác thực được công khai lên bảng ledger (red.anthropic.com); Anthropic báo cáo cho maintainer; cuối cùng maintainer tự xác thực và vá lỗi. Hai bước giữa — xác thực thủ công và vá lỗi — đều chạy bằng tốc độ con người, và đó chính là nơi mọi thứ tắc lại.
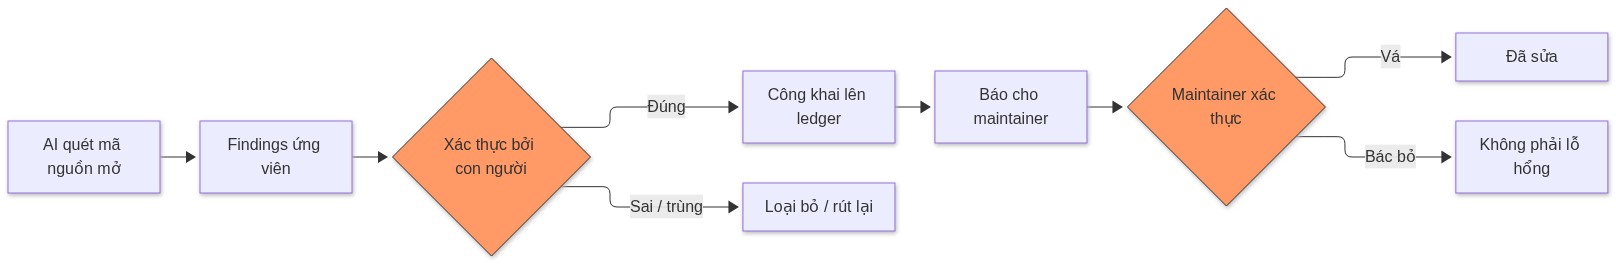
Tháng 5/2026, khi ledger lần đầu công bố, Anthropic báo cáo 23.019 findings với tỉ lệ true-positive 90,8%. Con số này nghe rất ấn tượng — nhưng “findings” không đồng nghĩa với “lỗ hổng đã xác nhận”.
Đọc đúng các con số: 37.966 không có nghĩa là 37.966 lỗ hổng
Sai lầm phổ biến nhất khi đọc tin về Project Glasswing là coi mọi con số đều như nhau. Thực tế, một finding đi qua bốn tầng trước khi trở thành một lỗi đã sửa: ứng viên do AI tạo ra, được công khai, đã báo cho maintainer, và cuối cùng là đã sửa. Mỗi tầng thu hẹp lại rất nhiều.
Tính tới cập nhật ledger ngày 2/11/2026, Project Glasswing báo cáo 37.966 findings. Trong đó chỉ 7.349 cái (19,4%) được công khai, và chỉ 217 cái được đánh dấu đã sửa — tức 0,57% tổng số, hay 2,9% số đã công khai. Cứ 175 findings AI tìm ra thì mới có 1 cái được sửa xong.
Tỉ lệ true-positive 94,2% mà Anthropic ghi trên ledger cũng cần đọc kèm dấu hỏi. Đây là tuyên bố của Anthropic, và VulnCheck — đơn vị theo dõi độc lập dự án này từ tháng 4 — công khai nghi ngờ cách tính của nó: số findings bị đánh dấu trùng lặp (1.670) và bị rút lại (419) cộng lại là 2.089, gấp gần 10 lần số đã sửa (217). Nếu tỉ lệ đúng thật sự là 94,2%, số bị loại không thể lớn gấp nhiều lần số được sửa — có thể ledger đang thiếu một vòng phản hồi, không trừ findings bị trùng lặp hoặc rút lại khỏi tỉ lệ true-positive.
Mức độ nghiêm trọng cũng vênh nhau: tháng 9, Claude đánh giá 91,5% findings trên ledger là critical hoặc high, trong khi các maintainer chỉ đánh giá 51,3% như vậy. Việc gán severity tự động chưa đáng tin để xếp hàng ưu tiên. VulnCheck còn phát hiện một lỗi trên chính ledger của Anthropic làm phồng số findings được đánh dấu “disclosed” — ai muốn kiểm tra thì dùng bộ lọc “disclosed” trên ledger để tự đối chiếu.
Cùng cái bẫy đếm số này từng xuất hiện trong bài GPT-6 Cyber tìm 948 lỗ hổng Linux kernel: 948 là số patch ứng viên mà model tạo ra, không phải 948 CVE đã vá. Đếm findings mà không đếm fixes thì bức tranh lúc nào cũng đẹp hơn thực tế.
Kết quả của Project Glasswing sau 7 tháng: bảng số liệu 8/9 so với 2/11
| Chỉ số | 8/9/2026 | 2/11/2026 | Thay đổi |
|---|---|---|---|
| Tổng findings | 26.153 | 37.966 | +11.813 |
| Công khai | 2.736 (10,5%) | 7.349 (19,4%) | +4.613 |
| Đã sửa | 202 | 217 | +15 |
| Rút lại | 245 | 419 | +174 |
| Trùng lặp | 2 | 1.670 | +1.668 |
| Tỉ lệ true-positive (Anthropic tuyên bố) | 91,4% | 94,2% | +2,8 điểm |
Nguồn: ledger công khai của Anthropic, cập nhật 2/11/2026, qua phân tích của VulnCheck (tháng 11/2026).
Đọc bảng này theo hàng ngang mới thấy vấn đề. Trong 8 tuần, findings tăng thêm 11.813 (tăng 45%), nhưng số đã sửa chỉ tăng 15. Trùng lặp tăng từ 2 lên 1.670 — VulnCheck từng cảnh báo từ tháng 9 rằng findings càng để lâu thì càng có khả năng người khác tìm ra và sửa trước.
VulnCheck còn đếm CVE thực tế gắn với Anthropic. Sau 7 tháng, họ đếm được 442 CVE — khoảng 0,5% tổng số CVE công bố trong năm 2026 (93.450 CVE). Trong đó, chỉ 2 cái bị khai thác ngoài thực tế (CVE-2026-61500 và CVE-2026-26980), tức 0,45%. AI tìm lỗi rất giỏi, nhưng phần lớn lỗi tìm được chưa từng bị kẻ tấn công chạm tới — và cũng chưa được sửa.
OSS Scanner: nút thắt chuyển từ Anthropic sang maintainer
Ngày 8/10/2026, Anthropic ra mắt OSS Scanner — công cụ quét mã nguồn mở mà các dự án tự nguyện tham gia (opt-in) trên GitHub, maintainer tự yêu cầu quét và tự phân loại kết quả. Anthropic nói thẳng trong thông báo ra mắt rằng các báo cáo này “hoàn toàn do model tạo ra, không có con người xem xét hay phân loại” và “có thể sai hoặc không hợp lệ”.
Lý do ra mắt OSS Scanner cũng được Anthropic thừa nhận công khai: họ tắc ở “năng lực con người để xác thực các findings”. Tới thời điểm đó, Project Glasswing đã tìm ra hơn 29.000 findings ứng viên nhưng đội ngũ chỉ xem xét thủ công được khoảng 6.000, và đã gửi gần 5.000 báo cáo chưa xác thực cho các maintainer yêu cầu nhận hàng loạt. Nút thắt xác thực không biến mất, nó chỉ chuyển từ Anthropic sang maintainer.
Trường hợp curl cho thấy cái giá của việc chuyển nút thắt này. Daniel Stenberg nhận một đợt 45 báo cáo từ Anthropic, trong đó chỉ 1 cái được đánh giá ở mức medium, còn lại đều low. Anh phải chuyển từng báo cáo lên GitHub một cách có kiểm soát “để giảm tác động lên nhóm”. Tính tới thời điểm VulnCheck phân tích, trong 34 báo cáo đã công khai: 19 cái bị đánh dấu không phải lỗ hổng, 6 cái xác nhận ở mức thấp, 9 cái đang chờ đánh giá. Tỉ lệ false positive tính tới lúc đó là 55,9%, và chỉ 17,6% findings được xác nhận — toàn bộ ở mức thấp. Hồi tháng 5, 5 findings của Mythos gửi cho curl cuối cùng cũng chỉ còn 1 lỗ hổng thật.
Bài học ở đây không phải “đừng dùng AI để quét”. SkillSpector của NVIDIA cũng dựa trên nguyên tắc tương tự: quét tự động chỉ có giá trị khi có vòng xác thực độc lập trước khi tin — quét skill AI trước khi cài, chấm điểm rủi ro 0–100, rồi con người mới quyết định. Với báo cáo lỗ hổng cũng vậy: AI tìm, con người xác thực, rồi mới hành động.
Checklist: maintainer và đội bảo mật xử lý báo cáo AI thế nào
Khi hộp thư của bạn bắt đầu nhận báo cáo do AI tạo ra, đừng xử lý chúng như báo cáo của một nhà nghiên cứu bảo mật. Quy trình dưới đây dùng cho cả maintainer mã nguồn mở lẫn đội bảo mật doanh nghiệp.
1. Ưu tiên theo khả năng khai thác, không theo severity do AI gán. Một finding “critical” theo Claude nhưng không có đường khai thác thực tế thì xếp sau một finding “medium” đã có PoC.
2. Yêu cầu bằng chứng tối thiểu trước khi xác thực sâu. Báo cáo không kèm PoC, không nêu rõ điều kiện kích hoạt, hoặc không chỉ ra được dòng code cụ thể thì trả lại với nhãn “needs-info”.
3. Kiểm tra trùng lặp trước khi mở ticket mới. Tra cứu tracker công khai của VulnCheck để xem finding này đã được báo hay sửa chưa:
git clone --depth 1 https://github.com/patrickmgarrity/Anthropic-Credited-CVEs4. Phân loại công khai và minh bạch. Học cách curl làm: công bố từng báo cáo dưới dạng issue, ghi rõ kết quả phân loại. Minh bạch giúp các dự án khác tránh xác thực trùng.
5. Đặt quy tắc tiếp nhận báo cáo AI. Chỉ nhận báo cáo qua kênh chỉ định, từ chối báo cáo gửi hàng loạt chưa xác thực, đặt SLA phản hồi — ví dụ xác nhận đã nhận trong 5 ngày làm việc.
6. Với đội bảo mật doanh nghiệp: đối chiếu với inventory của mình trước. Một finding chỉ đáng ưu tiên khi nó chạm tới dependency đang chạy trong hệ thống của bạn. Đối chiếu findings với SBOM rồi mới xếp hàng.
7. Không vá tự động theo báo cáo AI. Patch ứng viên cần được review như mọi pull request khác. Shannon — AI pentester cho web app và API — cũng vận hành theo nguyên tắc này: AI đề xuất, con người xác thực, rồi mới sửa.
8. Theo dõi tỉ lệ false positive của từng nguồn. Ghi lại tỉ lệ xác nhận/không phải lỗ hổng theo từng scanner theo thời gian. Nguồn nào liên tục cho false positive cao thì hạ mức ưu tiên xử lý.
Gotchas: những lỗi thường gặp khi đọc tin AI tìm lỗ hổng
Tin mù số findings. 37.966 là số ứng viên AI tạo ra, không phải số lỗ hổng đã xác nhận. Con số đáng quan tâm là 217 đã sửa.
Nhầm “đã báo” với “đã sửa”. Một finding được công khai trên ledger hay gửi cho maintainer chưa có nghĩa nó đã được vá — chỉ 2,9% số công khai được đánh dấu đã sửa.
Tin tỉ lệ true-positive của vendor mà không xem mẫu đối chứng. Ledger ghi 94,2%, nhưng mẫu đối chứng từ curl cho tỉ lệ false positive 55,9%. Theo mình, khi vendor tự chấm điểm cho chính mình thì con số đó chỉ là điểm khởi đầu, không phải kết luận.
Tin severity do AI gán. Claude đánh 91,5% findings là critical/high, maintainer chỉ đồng ý 51,3%. Severity là ý kiến, không phải sự thật — và ý kiến của AI vẫn cần hiệu chỉnh.
Bỏ qua trùng lặp và rút lại. 1.670 trùng lặp và 419 rút lại cộng lại gấp gần 10 lần số đã sửa. Một chương trình mà số bị loại tăng nhanh hơn số được sửa thì đang có vấn đề ở khâu xác thực đầu vào.
Nhầm “công khai” với “nguy hiểm”. Chỉ 2 trong 442 CVE gắn với Anthropic bị khai thác ngoài thực tế. Phần lớn lỗi AI tìm được chưa từng bị kẻ tấn công chạm tới — không phải finding nào cũng là trường hợp khẩn cấp.
Kết luận
- AI đã thắng ở khâu phát hiện — Project Glasswing tìm ra 37.966 findings trong 7 tháng — nhưng khâu xác thực và vá vẫn chạy bằng tốc độ con người, và đó mới là nút thắt thật sự.
- Đừng đánh giá một chương trình tìm lỗi bằng số findings; hãy đếm số đã sửa, số trùng lặp và tỉ lệ false positive qua mẫu đối chứng độc lập.
- Maintainer và đội bảo mật cần quy tắc tiếp nhận rõ ràng cho báo cáo AI: yêu cầu PoC, kiểm tra trùng lặp, công khai kết quả phân loại.
Bài học rút ra
- Đếm số đã sửa, không đếm số đã tìm: 217 trên 37.966 (0,57%) mới là thước đo thực chất của Project Glasswing sau 7 tháng.
- Mọi tỉ lệ true-positive do vendor tự báo đều cần mẫu đối chứng: curl cho thấy 55,9% false positive trong khi ledger ghi 94,2%.
- Severity do AI gán cần hiệu chỉnh: 91,5% critical/high theo Claude, 51,3% theo maintainer — đừng xếp hàng ưu tiên theo con số này.
- Báo cáo chưa xác thực gửi hàng loạt tạo gánh nặng thật: 45 báo cáo khiến maintainer curl phải công bố từng đợt để bảo vệ nhóm.
- Trùng lặp tăng theo thời gian: findings để lâu càng dễ bị người khác tìm và sửa trước — từ 2 lên 1.670 chỉ trong 8 tuần.
- Công khai minh bạch giúp cả hệ sinh thái: cách curl công khai từng báo cáo được VulnCheck khuyến nghị nhân rộng, vì nó giảm xác thực trùng và cho cộng đồng mẫu đối chứng thật.
Phạm vi xác minh
Kiểm tra ngày 11/11/2026. Các con số chính trong bài — 37.966 findings, 7.349 công khai, 217 đã sửa, bảng 8/9 so với 2/11, 442 CVE, 2 CVE bị khai thác, trường hợp curl với 45 báo cáo — đều đối chiếu trực tiếp với bài phân tích của VulnCheck (tháng 11/2026) và ledger của Anthropic (cập nhật 2/11/2026). Trang ledger của Anthropic là ứng dụng web render bằng JavaScript nên số liệu được đối chiếu qua phân tích của VulnCheck và bài audit độc lập trên DEV.to, cả hai đều trích cùng nguồn ledger. Tỉ lệ true-positive 94,2% là tuyên bố của Anthropic, đang bị VulnCheck tranh cãi — bài viết ghi rõ điều này. Các con số phụ từ dashboard của Anthropic (29.439 ứng viên, 516 đã vá) không dùng trong bài vì chưa đối chiếu được trực tiếp. Tác giả không chạy Project Glasswing hay OSS Scanner; mọi đánh giá dựa trên tài liệu công khai và phân tích độc lập, không phải trải nghiệm thực hành.
Bình luận
Bình luận được duyệt trước khi hiển thị.Đang tải bình luận…
Để lại bình luận